레이블이 NLP인 게시물을 표시합니다. 모든 게시물 표시

수요일, 8월 15, 2018

[Python] Ctypes를 활용한 C언어 연동 - 유니코드 한글 다루기

수요일, 8월 15, 2018

1. 개요
파이썬(Python)은 C언어를 기반으로 하기 때문에, C언어와의 연동이 비교적 자유롭다. 이 글에서는 윈도우(Windows) 환경에서 Python의 기본 모듈 중 하나인 Ctypes를 활용하여 C언어의 함수들을 사용하는 방법을 살펴볼 것이다. 특히 Python3의 기본 인코딩 방식인 유니코드 문자를 다루는 예제를 중점적으로 설명하도록 하겠다.

2. C언어 동적 연결 라이브러리(DLL) 만들기
윈도우 환경에서 Python으로 C언어의 함수들을 사용하려면, C언어를 기반으로 만들어진 DLL 파일(*.dll)이 필요하다. (cf. Linux/Unix 환경에서는 *.so 파일을 사용한다.) DLL 파일은 Visual Studio를 통해 간단하게 만들 수 있다. Visual C++ 항목의 새로운 프로젝트를 생성한다. 이때, 응용 프로그램 종류를 동적 연결 라이브러리(.dll)로 선택한다. 프로젝트 이름은 test_dll이라고 하자. Visual Studio 2017을 기준으로는 Windows 데스크톱 마법사를 선택할 시, 다음과 같은 팝업이 나온다.
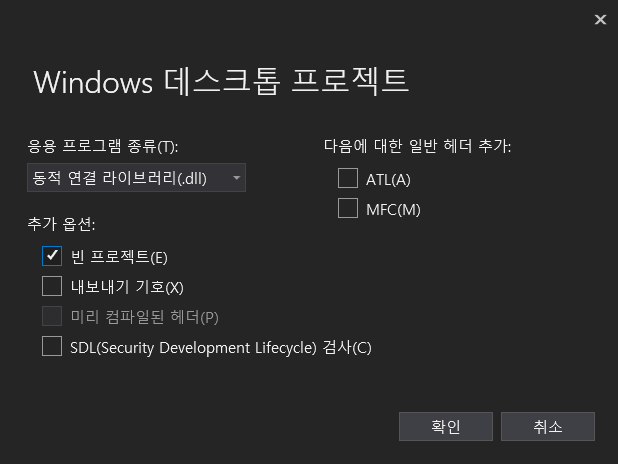
추가 옵션에서는 모두 체크를 풀고, 빈 프로젝트를 선택한다. 프로젝트가 생성되었다면 소스 파일에 C++ 파일을 하나 만들고, 다음과 같이 코드를 입력한다.
extern "C" __declspec(dllexport)
int sum(int a, int b) {
  return a + b;
}
이때, 첫 줄이 중요하다. 이 코드는 외부에서 DLL 파일을 통해 해당 함수를 접근할 수 있도록 알리는 역할을 한다. 만약, 함수 구현부 앞에 이 코드가 없다면 외부에서 인식할 수 없는 숨겨진 함수가 된다. Python 측에서 함수를 사용하고 싶다면 반드시 포함해야 하는 코드다.
빌드를 마치면, 솔루션이 위치한 경로에 DLL 파일이 생성되었다는 메시지가 출력된다.
test_dll.vcxproj -> <솔루션 경로>\Debug\test_dll.dll
이 위치에 가서 Python을 실행하거나, Python이 실행될 위치에 DLL 파일을 복사한 뒤 Python을 실행하고, 콘솔에 다음과 같은 명령어를 입력해보자.
>>> import ctypes as c
>>> mydll = c.WinDLL('test_dll')
아무런 메시지도 뜨지 않는다면, 정상적으로 DLL 파일을 불러왔다는 의미이다. 그런데, 다음과 같은 오류 메시지가 출력될 수도 있다.
>>> mydll = c.WinDLL('test_dll')
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
  File "C:\anaconda3\lib\ctypes\__init__.py", line 348, in __init__
    self._handle = _dlopen(self._name, mode)
OSError: [WinError 193] %1은(는) 올바른 Win32 응용 프로그램이 아닙니다
이는 64 bit 버전의 Python을 사용할 경우 발생할 수 있는 문제이다. DLL 파일이 32 bit 운영체제를 기준으로 만들어져 있기 때문이다. 따라서, 이 문제를 해결하기 위해서는 DLL 파일을 64 bit 버전으로 만들어주면 된다. Visual Studio의 상단 메뉴에서 x86 부분을 x64로 바꿔준 뒤 다시 빌드를 한다.
Debug를 선택했다면, DLL 파일이 <솔루션 경로>\x64\Debug에 생성될 것이고, Release를 선택했다면, <솔루션 경로>\x64\Release에 생성될 것이다. Python을 실행하고 새로 생성된 DLL 파일로 다시 불러오기를 시도할 경우, 정상적으로 동작이 될 것이다.

3. Python에서 C언어 함수 사용하기
DLL 파일을 성공적으로 불러왔다면, mydll이라는 변수에 DLL 파일의 정보가 담겨있을 것이다. 앞선 예시에서 C언어 측 코드에 extern "C" __declspec(dllexport)이 사용된 함수라면, 해당 함수의 이름이 Dictionary 형태로 mydll 변수에 저장되어 있다. 예를 들어, 앞서 정의한 sum 함수를 불러오기 위해서는 Python 콘솔에 다음과 같이 입력하면 된다.
>>> c_sum = mydll['sum']
c_sum은 이제 C언어 측에서 정의된 sum함수가 되며, 정의된 그대로 사용할 수 있다. 예를 들어, 다음과 같이 Python 함수처럼 사용할 수 있다.
>>> a = c_sum(3, 5)
>>> a
8
>>> type(a)
<class 'int'>
그런데, 이는 Python에서 사용하는 int와 C언어에서 사용하는 int의 형식이 서로 호환되기 때문에 가능한 것이다. 만약 함수의 인자나 반환 값에 다른 자료형(Data Type)을 사용하고자 한다면, Ctypes 모듈에 있는 C언어의 자료형들로 변환하여 사용해야 한다. 자세한 사항은 https://docs.python.org/3.6/library/ctypes.html에서 확인할 수 있으며, C언어의 자료형과 Python의 기본 자료형이 다음과 같이 1:1로 맵핑되어 있다.
엄밀하게 말하자면, 이러한 Ctypes의 자료형들을 사용하여 C언어 함수를 사용하기 전, 함수의 인자 타입과 리턴 타입을 명시해주어야 한다. c_sum 함수의 경우, 다음과 같이 설정하면 된다.
>>> c_sum.argtypes = (c.c_int, c.c_int)
>>> c_sum.restype = c.c_int

4. 유니코드 문자열 처리
int 이외에 char, float, double 등의 기본 자료형은 위 예시와 크게 다르지 않기 때문에 쉽게 사용할 수 있을 것이다. 그러나, 배열이나 문자열 등을 처리하는 것은 상대적으로 까다롭다. 이번에는 Python의 문자열을 C언어 측에서 처리하고 반환하는 과정을 예제로 살펴보도록 하겠다.
Python에서는 문자를 처리할 때, 기본적으로 2 Bytes의 유니코드를 사용한다. 이는 C++에서 wchar_t 자료형에 해당한다. 3의 표를 보면, Python의 문자열 형식이 C type 중 wchar_t의 포인터 형식과 일치하며, NULL 문자로 종료(NUL terminated)되는 문자열 배열이라는 사실을 확인할 수 있다.
따라서, 테스트용으로 두 개의 C 함수를 만들도록 한다. 첫 번째는, Python 측에서 문자열을 받아서 앞 두 글자를 바꾸는 함수이고, 두 번째는 Python 측에서 정수 n을 인자로 받아서 n 길이의 문자열을 반환해주는 함수이다.
extern "C" __declspec(dllexport)
void str_arg_test(wchar_t* c) {
  c[0] = L'안';
  c[1] = L'녕';
}
extern "C" __declspec(dllexport)
wchar_t* str_ret_test(int n) {
  wchar_t* ret = new wchar_t[n];
  wchar_t ch = L'가';
  int i;
  for (i = 0; i < n; i++) {
    ret[i] = ch + i;
  }
  ret[i] = 0;
  return ret;
}
이때, 주의할 점은 문자 리터럴을 사용할 때, 앞에 L을 붙여줘야 한다는 것이다. 영어 알파벳의 경우, 1 Byte의 char 자료형으로도 표현할 수 있어서 상관없지만, 한글처럼 2 Bytes의 유니코드를 사용해야 하는 경우, 해당 문자가 2 Bytes를 사용한다는 것을 C 컴파일러에게 알려줄 필요가 있다. 이러한 의도로 사용하는 것이 L이다. 만약, L을 사용하지 않는다면 Python 측에서 문자열을 반환받았을 때 한글이 깨지는 현상이 발생한다.
그리고, 두 번째 함수에서 맨 마지막 문자에 0을 대입하는데, 이는 문자열의 맨 끝이 NULL로 종료된다는 점을 반영한 것이다. 만약 이 부분을 생략하면, Python 측에서 문자열을 반환받았을 때, 문자열의 길이가 제멋대로가 되며 뒷부분에 의도치 않은 문자들이 포함된다.
이제 Python 측에서 두 함수를 불러오도록 하자. 콘솔에 다음과 같이 입력한다.
>>> f1 = mydll['str_arg_test']
>>> f2 = mydll['str_ret_test']
>>> f1.argtypes = (c.c_wchar_p, )
>>> f2.restype = c.c_wchar_p
이때 주의할 점이 몇 가지 있다. 우선 argtypes는 Python의 튜플(tuple) 형식으로 설정해야 하기 때문에, 인자가 하나만 필요할 경우 (인자 타입, ) 형식으로 설정한다. 그리고 f1의 경우 인자로 받은 문자열의 일부를 변경하는데, 이것이 Call by Reference 형식이기 때문에 함수가 종료되더라도 호출한 쪽에서 인자로 제공한 문자열에 변경 사항이 반영되어야 한다. 만약 Python의 문자열을 그대로 f1에 인자로 제공한다면, 함수가 동작은 하지만 함수가 끝났을 때 Python 측의 문자열에 변경 사항이 제대로 반영되지 않는다. 따라서, f1의 의도를 반영하려면, Python 측에서 문자열을 우선 Ctypes의 c_wchar_p 형식으로 변환한 뒤 인자로 제공해야 한다. 변환은 다음과 같이 간편하게 할 수 있다.
>>> test_str = '인사하세요'
>>> c_test_str = c.c_wchar_p(test_str)
>>> c_test_str.value
'인사하세요'
이제 준비된 것들을 바탕으로 테스트를 하면, 다음과 같은 결과를 얻을 수 있다.
>>> test_str
'인사하세요'
>>> c_test_str.value
'인사하세요'
>>> f1(test_str)
2
>>> test_str
'인사하세요'
>>> f1(c_test_str)
2
>>> c_test_str.value
'안녕하세요'
>>> f2(10)
'가각갂갃간갅갆갇갈갉'
반환받은 문자열을 배열처럼 사용하고 싶다면, list 함수를 활용하면 된다.
>>> list(f2(10))
['가', '각', '갂', '갃', '간', '갅', '갆', '갇', '갈', '갉']

5. Source Code
(1) test_dll.cpp
extern "C" __declspec(dllexport)
int sum(int a, int b) {
  return a + b;
}
extern "C" __declspec(dllexport)
void str_arg_test(wchar_t* c) {
  c[0] = L'안';
  c[1] = L'녕';
}
extern "C" __declspec(dllexport)
wchar_t* str_ret_test(int n) {
  wchar_t* ret = new wchar_t[n];
  wchar_t ch = L'가';
  int i;
  for (i = 0; i < n; i++) {
    ret[i] = ch + i;
  }
  ret[i] = 0;
  return ret;
}

(2) test_dll.py
import ctypes as c
# load dll
mydll = c.WinDLL('test_dll')
# load C functions
c_sum = mydll['sum']
f1 = mydll['str_arg_test']
f2 = mydll['str_ret_test']
# set argtypes and restype
c_sum.argtypes = (c.c_int, c.c_int)
c_sum.restype = c.c_int
f1.argtypes = (c.c_wchar_p, )
f2.restype = c.c_wchar_p
# test
c_sum(3, 5)
test_str = '인사하세요'
c_test_str = c.c_wchar_p(test_str)
c_test_str.value
f1(test_str)
f1(c_test_str)
print(test_str)
print(c_test_str.value)
print(list(f2(10)))

6. References
https://docs.python.org/3.6/library/ctypes.html

월요일, 9월 18, 2017

[Python] 텍스트 분류하기 (Text Classification)

월요일, 9월 18, 2017
1. 개요
이 글에서는 Python을 사용해서 문서의 내용 혹은 주제를 분류(Classification)하는 토이 프로젝트를 진행하는 것을 목표로 한다. 심화적인 내용보다는 기본적인 내용을 다루고, 이를 어떻게 개선하고 확장할 수 있는지 살펴볼 것이다.
우선 분류를 수행하기 위해서는 특정 정보를 바탕으로 학습된 모델이 필요하다. 이 프로젝트에서는 CNN의 기사들을 주제별로 크롤링(Crawling)한 뒤, 기사 전문과 그에 대한 라벨(주제)를 한 쌍으로 묶어서 트레이닝 데이터로 활용한다. 이를 통해 학습을 진행하고 특정 텍스트를 테스트 데이터로 제공했을 때 해당 텍스트가 어떤 주제에 속하는지 분류해주는 모델을 만든다. 여러가지 방법 중에서도 가장 대표적인 벡터 공간 모델(Vector Space Model)의 개념을 활용하도록 한다.

2. 트레이닝 데이터 준비
Python으로 CNN의 기사들을 크롤링해보자. 준비물로는 Python 모듈로 제공되는 Beautiful Soup, urllib, NLTK이다. 이 세 가지 모듈의 설치와 관련된 내용은 다른 포스트에서 다루도록 하겠다. 대략적으로 말하자면 Beautiful Soup와 urllib은 웹사이트로부터 데이터를 쉽게 크롤링하기 위한 도구이고, NLTK는 자연어처리와 관련된 다양한 전처리를 하기 위한 도구이다.
크롤링에 앞서 데이터를 긁어올 웹페이지가 어떠한 구조로 되어 있는지 확인할 필요가 있다. Chrome 브라우저를 통해 CNN의 웹페이지(http://edition.cnn.com)에 접속하여 특정 기사를 클릭한 뒤, F12를 눌러서 개발자 도구를 활성화하면 웹페이지의 구조를 확인할 수 있다.
이 프로젝트에서 필요한 것은 헤드라인과 본문의 텍스트 데이터뿐이므로, 이 부분들만 크롤링하도록 한다. 첫 단락은 p태그로 묶여 있고, 두 번째 단락부터 본문 끝까지는 div태그로 묶여있음에 유의해야 한다. 특정 기사의 URL로부터 헤드라인과 본문의 텍스트 데이터를 크롤링하여 문자열로 반환하는 것은 다음과 같이 Python 코드로 쉽게 구현할 수 있다.
import bs4
import urllib.request
htmlData = urllib.request.urlopen(inputurl)
bs = bs4.BeautifulSoup(htmlData, 'lxml')
bodies = bs.findAll('h1', 'pg-headline')
bodies += bs.findAll('p', 'zn-body__paragraph')
bodies += bs.findAll('div', 'zn-body__paragraph')
inputstr = ""
for body in bodies:
    inputstr += (body.getText() + " ")
이 코드는 문자열 타입의 URL(inputurl)을 받아 크롤링 결과물을 문자열(inputstr)로 만들어준다.
이를 통해 여러 기사들을 분류별로 나누어 파일로 저장해놓자. 우선 Entertainment, Golf, Politics 세 가지 주제에 대해 폴더를 만들어놓고, 각각의 폴더 안에 해당 주제에 대한 기사들을 20여개 정도 저장하였다. 문자열을 파일에 출력하는 것은 위의 코드와 Python에 기본으로 내장된 파일 입출력 관련 함수들(open, write 등)을 사용하여 간단히 구현하면 된다.

3. 분류 모델 준비
분류 모델은 다양한 방법으로 설계할 수 있다. 자연어처리의 영역에서 소개하는 여러 복잡한 방법들이 존재하지만, 우선 이 글에서는 가장 기초적이면서 대표적인 코사인 유사도(Cosine Similarity)를 활용하도록 한다. 위키피디아에 따르면 코사인 유사도의 정의는 다음과 같다.
코사인 유사도(― 類似度, 영어: cosine similarity)는 내적공간의 두 벡터간 각도의 코사인값을 이용하여 측정된 벡터간의 유사한 정도를 의미한다. 각도가 0°일 때의 코사인값은 1이며, 다른 모든 각도의 코사인값은 1보다 작다. 따라서 이 값은 벡터의 크기가 아닌 방향의 유사도를 판단하는 목적으로 사용되며, 두 벡터의 방향이 완전히 같을 경우 1, 90°의 각을 이룰 경우 0, 180°로 완전히 반대 방향인 경우 -1의 값을 갖는다.
그리고 두 벡터 A, B의 코사인 유사도를 구하는 공식은 다음과 같다.
즉, A와 B를 내적한 뒤 두 벡터의 길이의 곱으로 나눠주면 된다. 이는 NumPy를 사용한다면 Python 코드로 간단하게 구현할 수 있다.
import numpy
def cosSimilarity(A, B):
    multi = (A.dot(B))
    x = math.sqrt(A.dot(A))
    y = math.sqrt(B.dot(B))
    result = multi / (x * y)
    return result
그렇다면 이제 남은 것은 각각의 기사를 벡터화(Vectorization)하는 것이다. 물론 이 벡터화를 위한 방법론도 정말 다양하고 활발한 연구가 진행되고 있지만, 자세한 내용은 뒤에서 다루도록 하고 이 프로젝트에서는 가장 기초적인 방법부터 사용해보도록 하자.

우선 첫 번째로 할 일은 크롤링을 통해 수집한 기사들을 한 번씩 훑으면서, 사용된 모든 단어의 목록을 만드는 것이다. 이를 이후에는 편의상 Vocabulary라고 하겠다. 이 Vocabulary는 일종의 자료구조이며, 만족해야 할 조건은 트레이닝 데이터에 사용된 모든 단어를 중복없이 하나씩 포함해야 한다는 것이다. 그리고 각각의 단어들은 인덱싱을 통해 쉽게 접근할 수 있어야 한다. 예를 들어, "I love you"라는 트레이닝 데이터로부터 Vocabulary를 생성한다면, 다음과 같은 형태로 단어들이 저장될 것이다.
0: I
1: Love
2: You
간단히 1차원 배열로도 구현할 수 있으나, 이 Vocabulary라는 개념 자체가 자연어처리에서 널리 활용되는 개념이기 때문에 확장성을 고려하여 해싱(Hashing)을 사용한 자료구조로 만들도록 하자. 해싱을 적절히 사용한다면, Vocabulary에 저장된 단어에 대해 인덱스로도 접근이 가능한 동시에 단어 자체로도 접근이 가능하여 강력한 검색 기능을 탑재하게 된다.
이러한 조건들을 만족하는 Vocabulary 클래스를 만들어보자.
import numpy as np
# Set of vocabularies with indices
class Vocabulary:
    def __init__(self):
        self.vector = {}
    def add(self, tokens):
        for token in tokens:
            if token not in self.vector and not token.isspace() and token != '':
                self.vector[token] = len(self.vector)
    def indexOf(self, vocab):
        return self.vector[vocab]
    def size(self):
        return len(self.vector)
    def at(self, i): # get ith word in the vector
        return list(self.vector)[i]
    # vectorize = dict -> numpy.array
    def vectorize(self, word):
        v = [0 for i in range(self.size())]
        if word in self.vector:
            v[self.indexOf(word)] = 1
        else:
            print("<ERROR> Word \'" + word + "\' Not Found")
        return np.array(v)
    def save(self, filename):
        f = open(filename, 'w', encoding='utf-8')
        for word in self.vector:
            f.write(word + '\n')
        f.close()
    def load(self, filename):
        f = open(filename, 'r', encoding='utf-8')
        lines = f.readlines()
        bow = [i[:-1] for i in lines]
        self.add(bow)
        f.close()
    def __str__(self):
        s = "Vocabulary("
        for word in self.vector:
            s += (str(self.vector[word]) + ": " + word + ", ")
        if self.size() != 0:
            s = s[:-2]
        s += ")"
        return s
코드를 살펴보면 알겠지만, Python에서 기본적으로 제공하는 Dictionary 자료구조가 Hash Set과 동일한 역할을 해주기 때문에 이를 기본으로 하되, index를 통해 접근할 수 있도록 at()과 indexOf()같은 함수들을 구현해 두었다.

4. 분류 모델 학습
모든 준비가 완료되었으므로 실제 모델을 학습하는 것만 남았다. 먼저 앞서 구현한 Vocabulary 클래스를 통해 트레이닝 데이터로 준비한 60개의 문서에 대해 Vocabulary를 생성해야 한다. 이 Vocabulary를 활용하여 각 문서에 나타나는 단어들의 빈도수를 체크하고, 이를 바탕으로 문서 자체를 벡터화하여 분류 기준을 마련할 것이다. 즉, 문서 하나를 벡터 공간 내에서 하나의 점으로 표현하는 Vector Space Model의 개념을 따르는 것이다.

그런데, 한 가지 주의할 사항이 있다. 문서에서 단어들을 어떻게 뽑아낼 것인가? 띄어쓰기(공백 문자)를 기준으로 끊어서 하나의 단어라고 할 수도 있을 것이다. 하지만, 이러한 방법을 채택할 경우 다음과 같은 문장으로부터 어떤 단어를 얻게 될까?
나는 사과를 좋아하는데, 영희는 사과만 싫어한다.
정답은 ["나는", "사과를", "좋아하는데,", "영희는", "사과만", "싫어한다."]이다. 우선 쉼표나 온점같은 특수문자가 단어에 포함된다. 이는 문서의 의미를 이해하는데 꼭 필요한 정보라고는 할 수 없다. 그리고 상식적으로 "사과"라는 단어가 이 문장의 키워드 중 하나라고 여길 수 있는데, 이것이 하나의 단어로 뽑히는 것이 아니라 "사과를", 그리고 "사과만" 두 가지 형태로 나타나게 된다. 앞선 경우와 마찬가지로 우리말의 조사는 큰 의미를 반영하지 않는다. 게다가 단어의 빈도수를 측정할 때 문제를 야기할 소지가 있다. "사과"와 관련된 문서를 찾기 위해 "사과"라는 단어가 가장 많이 포함된 문서를 찾으려고 하는데, 모든 문서 내에 "사과를", "사과만"이라는 단어만 잔뜩 포함되어 있다면 정상적인 시스템이라고 할 수 없지 않는가. 따라서 이러한 불필요한 요소들을 제거할 필요성이 있다.

이를 위해 트레이닝 데이터로부터 Vocabulary를 형성하기 전에 전처리를 수행해주도록 하자. 앞서 언급했던 여러가지 불필요한 요소들을 Stop Words라고 부르고, 우리말의 조사나 영어의 복수형에 붙는 s 등을 없앤 어간을 Stem이라고 한다. 이들을 처리하기 위한 유용한 툴이 NLTK 라이브러리에 전부 구현되어 있다. 필요한 부분에 가져다 쓰기만 하면 된다.

크롤링을 통해 긁어온 문자열을 Input으로 받아서 Stop Words를 제거하고 Stem만 남겨주는 preprocess() 함수를 구현하자.
import nltk
from nltk.corpus import stopwords

# preprocess = str -> nltk.Text
def preprocess(inputstr):
    inputstr = inputstr.lower()
    tokens = nltk.word_tokenize(inputstr)
    stpwrds = set(stopwords.words('english'))
    tokens = [i for i in tokens if i not in stpwrds and i.isalpha()]
    stemmer = nltk.stem.porter.PorterStemmer()
    stems = [stemmer.stem(i) for i in tokens]
    text = nltk.Text(stems)
    return text
중간에 PorterStemmer()라는 것은 Stem을 만들어주는 여러가지 방법 중 Porter Stemming Algorithm을 사용한다는 뜻이다. 이외에도 여러가지 방법들이 있고, 함수로 구현되어 있으니 관심이 있다면 직접 검색해보길 권한다.

이제 이 전처리를 수행한 뒤 모든 트레이닝 데이터에 대해 Vocabulary에 단어들을 수집하면 된다. preprocess() 함수는 nltk.Text 타입의 객체를 반환하는데, 이 객체의 내부 함수인  vocab() 함수를 호출하면 단어로 이루어진 리스트(List) 자료구조를 반환한다.

다음과 같은 방식으로 코드를 작성하면 된다. x_training_file이라는 파일 안에는 트레이닝 데이터로 활용하고자 하는 문서 중 주제가 x에 해당하는 문서들의 URL이 20개 저장되어 있다고 가정한다. 그리고 getTextFromURL() 함수는 2에서 설명한 방식대로 URL을 Input으로 받아 문자열을 Output으로 반환하는 함수이다.
myvoc = Vocabulary()
f = open(PATH_TRAINING_DATA + golf_training_file)
lines = f.readlines()
for line in lines:
    tmp = getTextFromURL(line)
    bow = preprocess(tmp)
    myvoc.add(bow)
f.close()
이러한 방식으로 모든 트레이닝 데이터에 대해 단어를 수집하면 된다. Vocabulary가 완성되었다면, 본격적으로 Vocabulary 클래스의 vectorize() 함수를 통해 단어 하나를 One-hot Encoding 방식으로 벡터화할 수 있다.
myvoc.vectorize("apple")
이를 활용하여 한 문서에 존재하는 모든 단어들을 벡터로 만들고, 그 벡터들을 전부 더하도록 하자. 그렇다면 문서 하나가 하나의 벡터가 되는데, 쉽게 생각하면 이 벡터는 문서 하나에 나타나는 단어들의 빈도수를 표현하게 되는 것이다. One-hot Encoding 방식으로 단어가 벡터화되었기 때문에 같은 단어가 여러 번 나타날 경우, 해당 단어의 인덱스에 해당하는 벡터의 원소만 증가하게 된다.
이 개념을 통해 트레이닝 데이터셋의 모든 문서들을 각각 벡터로 만들고, 주제별로 평균을 내도록 하자. 이 평균값이 해당 주제에 대한 대표 벡터이자 분류 기준이라고 보면 된다. 참고로 이 글에서는 Cosine Similarity를 사용하기 때문에, 평균을 구하지 않고 각 벡터들의 합만 구해도 된다. 벡터의 방향성이 얼마나 유사한지를 판단하는 방법이라 벡터의 길이는 상관이 없기 때문이다.

Entertainment, Golf, Politics 세 가지 주제에 대해 각각 벡터를 하나씩 얻었다면, 분류 모델이 완성된 것이다. 이를 통해 특정 문서에 대한 분류를 수행하기 위해서는 문서를 벡터화하는 과정을 동일하게 진행한 뒤, 해당 벡터를 준비된 세 가지 벡터들과 각각 비교하여 가장 Cosine Similarity가 높은 주제로 분류를 하면 된다. 주의할 점은, 학습 모델을 만들 때 사용한 Vocabulary를 그대로 사용해야 한다는 것이다. 그래야 특정 단어가 학습 모델에 맞게 제대로 벡터화되기 때문이다.

굉장히 간단하고 기초적인 모델이지만, 직접 분류를 해보면 꽤 의도한 대로 결과가 나오는 것을 확인할 수 있다. 실제 실험을 진행한 뒤 Matplotlib와 같은 라이브러리를 통해 시각화를 했더니 다음과 같은 결과가 나타났다.
Entertainment, Golf, Politics 세 가지 주제에 대해 각각 하나씩의 임의의 CNN 기사를 크롤링하여 분류를 한 결과 세 가지 경우 모두 정답을 도출했다.

5. 향후 발전방향
이 기초적인 프로젝트를 개선하고 확장하면 더욱 높은 성능을 기대할 수 있다. 이를 위해서 어떠한 점들을 개선해야 하는지 몇 가지 살펴보도록 하겠다.

우선, 각 벡터 사이의 유사도를 측정하는데 있어서 Cosine Similarity 이외에 자카드 유사도(Jaccard Similarity)를 구하는 방법도 많이 쓰인다. 두 방법 중 한 가지를 선택하거나, 둘을 적절히 조합하여 유사도를 측정하는 방식을 쓸 수도 있다. 모델을 설계하는 단계에서 입맛대로 사용하면 된다.

또한 Vocabulary를 생성하는 과정에서 Stop Word들을 제거하거나 Stemmer를 사용함에 있어서 과연 무조건적인 Stop Words의 배제가 바람직한 것인지, 특정 Stemmer의 성능이 어떠한 경우에 좋은지 등 추가적으로 고려할 요소들이 많다.

사실, 가장 중요한 부분은 바로 문서, 단어를 벡터화하는 방식이다. 이 글에서는 그저 단어들의 빈도수를 도출해서 그것들을 합한 것에 지나지 않지만, 실제 정보 검색 분야나 자연어처리 분야에서는 Doc2Vec, Word2Vec 등 머신러닝 기반의 다양한 벡터화 방법론이나 TF-IDF처럼 문서와 관련하여 각 단어의 중요도에 대해 고려하는 통계적 기법들이 널리 활용되고 있다. 특히 TF-IDF는 각 문서의 주제와 직결되는 중요한 단어들이 무엇인지 고려해준다는 점에서, 앞서 언급했던 Stop Word의 존재에 대한 걱정거리를 어느정도 덜어주기도 한다.

이러한 다양한 방법들을 적절히 조합하고 적용하면 더욱더 강력한 텍스트 분류 모델이 완성될 것이다. 이 글의 토이 프로젝트를 통해 가장 기본적인 요소들에 대해 학습하고, 향후 개선과 확장을 통해 고도의 분류 시스템을 설계하는 단계까지 나아가도록 하자.

6. References
https://ko.wikipedia.org/wiki/%EC%BD%94%EC%82%AC%EC%9D%B8_%EC%9C%A0%EC%82%AC%EB%8F%84

금요일, 10월 21, 2016

영어 문장의 중의성 (Ambiguity of English sentences) - English Semantics

금요일, 10월 21, 2016

Semantics의 관점에서 영어 문장에는 다양한 종류의 중의성이 존재한다. 대표적인 예로 Lexical ambiguity, Structural ambiguity, Scope ambiguity가 있다. 이는 원활한 의사소통을 제한하기 때문에 대화 또는 작문 뿐만 아니라 자연어처리(Natural Language Processing, NLP)에서도 신경써줘야 할 부분이다.

예시와 함께 세 가지의 예시를 살펴보도록 하자.

1. Lexical ambiguity
Lexical ambiguity는 단어 의미의 다양성에 기인하는 중의성이다.
"Tom likes his new pen"이라는 문장의 해석은 두 가지가 될 수 있다. 첫 번째는 "톰이 그의 새 펜을 좋아한다."라는 뜻이고, 다른 하나는 "톰이 그의 새로운 울타리를 좋아한다."라는 뜻이다. 이는 pen이라는 단어가 각각 펜, 울타리라는 다른 뜻으로 해석되기 때문에 발생하는 중의성이다.
한 가지 주의할 점은, 다의어(Polysemy)는 이 Lexical ambiguity에 해당하지 않는다는 점이다. Polysemy라는 것과 앞서 살펴본 pen의 차이는, 간단하게 생각해서, 다양한 의미들 사이에 연관성이 있느냐 없느냐이다.
즉, 펜과 울타리는 pen이라는 단어 하나에서 나온 뜻이지만, 둘 사이의 연관성이 존재하지 않는다. 이 경우에는 Lexical ambiguity에 해당한다. 사전에 찾아보면 아예 pen1, pen2 이런식으로 따로 구분을 하는 것을 볼 수 있다. 또다른 예로는 bank를 들 수 있다. 은행이라는 뜻도 있지만, 둑, 제방이라는 전혀 연관성이 없는 뜻도 존재한다.
반면에, Polysemy는 의미간에 연관성이 있는 경우이다. 예를 들어, "Something or someone that has a mouth and a fork but cannot eat"이라는 수수께끼의 경우 답이 강(river)인데, 이는 mouth가 입구라는 의미로 해석되고 fork가 갈래로 나누어지는 것을 형상화한 것으로 해석되기 때문이다. 즉, 여기서 mouth는 입이라는 뜻도 있지만 입구라는 뜻으로 해석이 되었는데, 입과 입구는 연관성이 있다고 볼 수 있다. 입도 몸속으로 통하는 입구라고 할 수 있기 때문이다. 이런 경우는 Ambiguity의 범주에 속하지 않는다.

2. Structural ambiguity
Structural ambiguity는 구문적으로(Syntactically) ambiguous한 경우이다.
예를 들어, "The student saw a cat under the table"이라는 문장의 해석은 두 가지가 될 수 있는데, 하나는 "그 학생은 탁자 밑에서 고양이를 보았다"이고, 다른 하나는 "그 학생은 탁자 밑에 있는 고양이를 보았다"이다. 이는 Syntactic tree를 그려보았을 때, PP(Prepositional Phrase)인 "under the table"이 어디에 그려지게 되느냐에 따라 달라지는 것이다. 첫 번째 의미는 PP가 동사 "보았다"와 sister가 되어 다음과 같은 트리가 될 것이다.
그리고 두 번째 문장은 PP가 목적어인 "고양이"와 sister가 되어 다음과 같은 트리가 될 것이다.
3. Scope ambiguity
수량사(Quantifier), 한정사(Determiner), 그리고 부정(Negation) 표현이 한 문장안에 혼합되어 여러개 쓰일 경우, 그 표현들의 영향을 받는 단어의 범위에 기인한 Ambiguity이다.
예를 들어, "Every boy loves a girl"이라는 문장에서 every라는 수량사와 a라는 한정사 때문에 두 가지로 해석될 수 있다.
첫 번째는 every가 a보다 넓은 범위(scope)를 포괄하고, a가 every의 scope안에 속하게 되는 경우이다. 이는 every<a>라고 표기할 수 있다. Paraphrase를 통해 문장을 다시 써보면, "For every boy, there is a girl he loves"이 된다. 이때 every와 a의 scope를 표기하면 다음과 같이 나타난다.
"For every [boy, there is a [girl he loves]]"
every boy 쪽에 초점이 맞춰져서 "모든 소년들은 각각 한 명의 소녀를 사랑한다"라고 해석된다.
그리고 두 번째는 a가 every보다 넓은 범위를 포괄하는 경우이다. 즉, a<every>의 경우이며, Paraphrase를 통해 문장을 다시 쓰면 "There is a girl that every boy loves"가 된다. 이때 scope를 표기하면 다음과 같이 나타난다.
"There is a [girl that every [boy loves]]"
즉, a girl 쪽에 초점이 맞춰져서 "한 명의 소녀가 있는데, 모든 소년들이 그녀를 사랑한다"라는 의미가 된다.
또 다른 예로는 Negation이 쓰인 형태로, "Every student did not listen to the teacher"를 들 수 있다. 이 경우에는 Every와 not의 Scope 관계 때문에 Ambiguity가 생긴다.
첫 번째로 every<not>의 경우 Paraphrase를 하면 "No student listened to the teacher"가 된다. 즉, every student 쪽에 초점이 맞춰져서 "모든 학생이 선생님의 말씀을 듣지 않았다"가 되는 것이다.
두 번째로 not<every>의 경우 Paraphrase를 하면 "Some student listened to the teacher"가 된다. 즉, not 쪽에 초점이 맞춰지고 not이 every가 포괄하는 전체 범위를 부정하는 것이 되기 때문에 "그래도 몇몇의 학생은 선생님의 말씀을 들었다"라는 의미가 되는 것이다.
첫 번째 경우의 Scope를 나타내기 위해 더욱 상세하게 Paraphrase를 하면, "For every [student, it is not the case that [he/she listened to the teacher]]"가 된다.
그리고 두 번째 경우의 Scope를 더욱 Paraphrase하여 나타내면, "It's not the case that [every [student listened to the teacher]]"가 된다.
눈치 챘겠지만, Paraphrase를 할 때 not은 "it is not the case that~"으로 바꾸고, a는 "There is a~" 형태로 바꾸고, every의 경우 "For every ~"의 형태로 바꾸면 용이하다는 것을 알 수 있다.