레이블이 C++인 게시물을 표시합니다. 모든 게시물 표시

수요일, 8월 15, 2018

[Python] Ctypes를 활용한 C언어 연동 - 유니코드 한글 다루기

수요일, 8월 15, 2018

1. 개요
파이썬(Python)은 C언어를 기반으로 하기 때문에, C언어와의 연동이 비교적 자유롭다. 이 글에서는 윈도우(Windows) 환경에서 Python의 기본 모듈 중 하나인 Ctypes를 활용하여 C언어의 함수들을 사용하는 방법을 살펴볼 것이다. 특히 Python3의 기본 인코딩 방식인 유니코드 문자를 다루는 예제를 중점적으로 설명하도록 하겠다.

2. C언어 동적 연결 라이브러리(DLL) 만들기
윈도우 환경에서 Python으로 C언어의 함수들을 사용하려면, C언어를 기반으로 만들어진 DLL 파일(*.dll)이 필요하다. (cf. Linux/Unix 환경에서는 *.so 파일을 사용한다.) DLL 파일은 Visual Studio를 통해 간단하게 만들 수 있다. Visual C++ 항목의 새로운 프로젝트를 생성한다. 이때, 응용 프로그램 종류를 동적 연결 라이브러리(.dll)로 선택한다. 프로젝트 이름은 test_dll이라고 하자. Visual Studio 2017을 기준으로는 Windows 데스크톱 마법사를 선택할 시, 다음과 같은 팝업이 나온다.
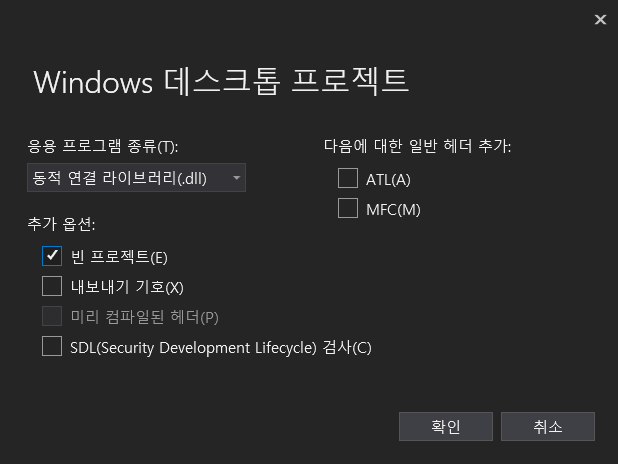
추가 옵션에서는 모두 체크를 풀고, 빈 프로젝트를 선택한다. 프로젝트가 생성되었다면 소스 파일에 C++ 파일을 하나 만들고, 다음과 같이 코드를 입력한다.
extern "C" __declspec(dllexport)
int sum(int a, int b) {
  return a + b;
}
이때, 첫 줄이 중요하다. 이 코드는 외부에서 DLL 파일을 통해 해당 함수를 접근할 수 있도록 알리는 역할을 한다. 만약, 함수 구현부 앞에 이 코드가 없다면 외부에서 인식할 수 없는 숨겨진 함수가 된다. Python 측에서 함수를 사용하고 싶다면 반드시 포함해야 하는 코드다.
빌드를 마치면, 솔루션이 위치한 경로에 DLL 파일이 생성되었다는 메시지가 출력된다.
test_dll.vcxproj -> <솔루션 경로>\Debug\test_dll.dll
이 위치에 가서 Python을 실행하거나, Python이 실행될 위치에 DLL 파일을 복사한 뒤 Python을 실행하고, 콘솔에 다음과 같은 명령어를 입력해보자.
>>> import ctypes as c
>>> mydll = c.WinDLL('test_dll')
아무런 메시지도 뜨지 않는다면, 정상적으로 DLL 파일을 불러왔다는 의미이다. 그런데, 다음과 같은 오류 메시지가 출력될 수도 있다.
>>> mydll = c.WinDLL('test_dll')
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
  File "C:\anaconda3\lib\ctypes\__init__.py", line 348, in __init__
    self._handle = _dlopen(self._name, mode)
OSError: [WinError 193] %1은(는) 올바른 Win32 응용 프로그램이 아닙니다
이는 64 bit 버전의 Python을 사용할 경우 발생할 수 있는 문제이다. DLL 파일이 32 bit 운영체제를 기준으로 만들어져 있기 때문이다. 따라서, 이 문제를 해결하기 위해서는 DLL 파일을 64 bit 버전으로 만들어주면 된다. Visual Studio의 상단 메뉴에서 x86 부분을 x64로 바꿔준 뒤 다시 빌드를 한다.
Debug를 선택했다면, DLL 파일이 <솔루션 경로>\x64\Debug에 생성될 것이고, Release를 선택했다면, <솔루션 경로>\x64\Release에 생성될 것이다. Python을 실행하고 새로 생성된 DLL 파일로 다시 불러오기를 시도할 경우, 정상적으로 동작이 될 것이다.

3. Python에서 C언어 함수 사용하기
DLL 파일을 성공적으로 불러왔다면, mydll이라는 변수에 DLL 파일의 정보가 담겨있을 것이다. 앞선 예시에서 C언어 측 코드에 extern "C" __declspec(dllexport)이 사용된 함수라면, 해당 함수의 이름이 Dictionary 형태로 mydll 변수에 저장되어 있다. 예를 들어, 앞서 정의한 sum 함수를 불러오기 위해서는 Python 콘솔에 다음과 같이 입력하면 된다.
>>> c_sum = mydll['sum']
c_sum은 이제 C언어 측에서 정의된 sum함수가 되며, 정의된 그대로 사용할 수 있다. 예를 들어, 다음과 같이 Python 함수처럼 사용할 수 있다.
>>> a = c_sum(3, 5)
>>> a
8
>>> type(a)
<class 'int'>
그런데, 이는 Python에서 사용하는 int와 C언어에서 사용하는 int의 형식이 서로 호환되기 때문에 가능한 것이다. 만약 함수의 인자나 반환 값에 다른 자료형(Data Type)을 사용하고자 한다면, Ctypes 모듈에 있는 C언어의 자료형들로 변환하여 사용해야 한다. 자세한 사항은 https://docs.python.org/3.6/library/ctypes.html에서 확인할 수 있으며, C언어의 자료형과 Python의 기본 자료형이 다음과 같이 1:1로 맵핑되어 있다.
엄밀하게 말하자면, 이러한 Ctypes의 자료형들을 사용하여 C언어 함수를 사용하기 전, 함수의 인자 타입과 리턴 타입을 명시해주어야 한다. c_sum 함수의 경우, 다음과 같이 설정하면 된다.
>>> c_sum.argtypes = (c.c_int, c.c_int)
>>> c_sum.restype = c.c_int

4. 유니코드 문자열 처리
int 이외에 char, float, double 등의 기본 자료형은 위 예시와 크게 다르지 않기 때문에 쉽게 사용할 수 있을 것이다. 그러나, 배열이나 문자열 등을 처리하는 것은 상대적으로 까다롭다. 이번에는 Python의 문자열을 C언어 측에서 처리하고 반환하는 과정을 예제로 살펴보도록 하겠다.
Python에서는 문자를 처리할 때, 기본적으로 2 Bytes의 유니코드를 사용한다. 이는 C++에서 wchar_t 자료형에 해당한다. 3의 표를 보면, Python의 문자열 형식이 C type 중 wchar_t의 포인터 형식과 일치하며, NULL 문자로 종료(NUL terminated)되는 문자열 배열이라는 사실을 확인할 수 있다.
따라서, 테스트용으로 두 개의 C 함수를 만들도록 한다. 첫 번째는, Python 측에서 문자열을 받아서 앞 두 글자를 바꾸는 함수이고, 두 번째는 Python 측에서 정수 n을 인자로 받아서 n 길이의 문자열을 반환해주는 함수이다.
extern "C" __declspec(dllexport)
void str_arg_test(wchar_t* c) {
  c[0] = L'안';
  c[1] = L'녕';
}
extern "C" __declspec(dllexport)
wchar_t* str_ret_test(int n) {
  wchar_t* ret = new wchar_t[n];
  wchar_t ch = L'가';
  int i;
  for (i = 0; i < n; i++) {
    ret[i] = ch + i;
  }
  ret[i] = 0;
  return ret;
}
이때, 주의할 점은 문자 리터럴을 사용할 때, 앞에 L을 붙여줘야 한다는 것이다. 영어 알파벳의 경우, 1 Byte의 char 자료형으로도 표현할 수 있어서 상관없지만, 한글처럼 2 Bytes의 유니코드를 사용해야 하는 경우, 해당 문자가 2 Bytes를 사용한다는 것을 C 컴파일러에게 알려줄 필요가 있다. 이러한 의도로 사용하는 것이 L이다. 만약, L을 사용하지 않는다면 Python 측에서 문자열을 반환받았을 때 한글이 깨지는 현상이 발생한다.
그리고, 두 번째 함수에서 맨 마지막 문자에 0을 대입하는데, 이는 문자열의 맨 끝이 NULL로 종료된다는 점을 반영한 것이다. 만약 이 부분을 생략하면, Python 측에서 문자열을 반환받았을 때, 문자열의 길이가 제멋대로가 되며 뒷부분에 의도치 않은 문자들이 포함된다.
이제 Python 측에서 두 함수를 불러오도록 하자. 콘솔에 다음과 같이 입력한다.
>>> f1 = mydll['str_arg_test']
>>> f2 = mydll['str_ret_test']
>>> f1.argtypes = (c.c_wchar_p, )
>>> f2.restype = c.c_wchar_p
이때 주의할 점이 몇 가지 있다. 우선 argtypes는 Python의 튜플(tuple) 형식으로 설정해야 하기 때문에, 인자가 하나만 필요할 경우 (인자 타입, ) 형식으로 설정한다. 그리고 f1의 경우 인자로 받은 문자열의 일부를 변경하는데, 이것이 Call by Reference 형식이기 때문에 함수가 종료되더라도 호출한 쪽에서 인자로 제공한 문자열에 변경 사항이 반영되어야 한다. 만약 Python의 문자열을 그대로 f1에 인자로 제공한다면, 함수가 동작은 하지만 함수가 끝났을 때 Python 측의 문자열에 변경 사항이 제대로 반영되지 않는다. 따라서, f1의 의도를 반영하려면, Python 측에서 문자열을 우선 Ctypes의 c_wchar_p 형식으로 변환한 뒤 인자로 제공해야 한다. 변환은 다음과 같이 간편하게 할 수 있다.
>>> test_str = '인사하세요'
>>> c_test_str = c.c_wchar_p(test_str)
>>> c_test_str.value
'인사하세요'
이제 준비된 것들을 바탕으로 테스트를 하면, 다음과 같은 결과를 얻을 수 있다.
>>> test_str
'인사하세요'
>>> c_test_str.value
'인사하세요'
>>> f1(test_str)
2
>>> test_str
'인사하세요'
>>> f1(c_test_str)
2
>>> c_test_str.value
'안녕하세요'
>>> f2(10)
'가각갂갃간갅갆갇갈갉'
반환받은 문자열을 배열처럼 사용하고 싶다면, list 함수를 활용하면 된다.
>>> list(f2(10))
['가', '각', '갂', '갃', '간', '갅', '갆', '갇', '갈', '갉']

5. Source Code
(1) test_dll.cpp
extern "C" __declspec(dllexport)
int sum(int a, int b) {
  return a + b;
}
extern "C" __declspec(dllexport)
void str_arg_test(wchar_t* c) {
  c[0] = L'안';
  c[1] = L'녕';
}
extern "C" __declspec(dllexport)
wchar_t* str_ret_test(int n) {
  wchar_t* ret = new wchar_t[n];
  wchar_t ch = L'가';
  int i;
  for (i = 0; i < n; i++) {
    ret[i] = ch + i;
  }
  ret[i] = 0;
  return ret;
}

(2) test_dll.py
import ctypes as c
# load dll
mydll = c.WinDLL('test_dll')
# load C functions
c_sum = mydll['sum']
f1 = mydll['str_arg_test']
f2 = mydll['str_ret_test']
# set argtypes and restype
c_sum.argtypes = (c.c_int, c.c_int)
c_sum.restype = c.c_int
f1.argtypes = (c.c_wchar_p, )
f2.restype = c.c_wchar_p
# test
c_sum(3, 5)
test_str = '인사하세요'
c_test_str = c.c_wchar_p(test_str)
c_test_str.value
f1(test_str)
f1(c_test_str)
print(test_str)
print(c_test_str.value)
print(list(f2(10)))

6. References
https://docs.python.org/3.6/library/ctypes.html

일요일, 11월 05, 2017

[C/C++] 고정 소수점의 모든 것 (All about Fixed Point)

일요일, 11월 05, 2017
1. 개요
이 글에서는 일반적으로 널리 사용되는 부동 소수점(Floating Point)과 달리 다소 생소한 고정 소수점(Fixed Point)에 대해 알아본다. 일부 프로그래밍 언어의 경우 고정 소수점 방식을 기본적으로 제공해주기도 하지만, 많은 경우 실수 표현에 있어서 부동 소수점 방식을 기반으로 하기 때문에 고정 소수점 방식을 사용하고자 한다면 직접 구현하거나, 외부 라이브러리를 통해 사용해야 한다는 불편함이 있다. 이 글은 C++ 언어를 사용하여 고정 소수점을 직접 구현해보면서 깊은 이해를 하는 것을 목표로 한다.
우선 고정 소수점의 정의부터 간단히 정리한 후에 부동 소수점 방식의 수를 고정 소수점 방식으로 변환(Floating Point to Fixed Point Conversion)하는 법, 그리고 고정 소수점 방식에서의 사칙연산(Arithmetic Operations)에 대해서 코드와 함께 살펴보도록 하겠다. 이후 고정 소수점 방식을 사용하는 이유나 소수점의 위치를 설정하는 방법 등 심화적인 내용에 대해 다룰 것이다. 이 글에서 설명에 사용된 모든 코드는 깃허브(Github)에 업로드되어 있으므로, 전체적인 코드를 보고 싶다면 한 번 살펴보길 권한다.

2. 고정 소수점의 정의
고정 소수점은 쉽게 말해서 특정 숫자의 소수점의 위치를 말그대로 고정하는 방식을 뜻한다. 컴퓨터 언어에서의 데이터 타입은 항상 최대 길이가 고정되어 있기 때문에 이러한 아이디어가 생긴 것이라고 생각할 수 있다. 예를 들어, 32-bit 운영체제에서 int형의 크기는 32비트이므로 앞의 10개의 비트는 정수 부분을 표현하도록 하고, 나머지 22개의 비트는 소수점 이하의 부분을 표현하도록 할 수 있다. 소수점 위치를 어디로 설정해야 하는지에 대해서는 정해진 답이 없다. 사용자의 임의대로 설정하면 된다. 다만, 사용하는 수의 범위를 감안하여 오버플로우(Overflow)가 발생하지 않도록 설정해야 한다. 이와 관련된 내용은 뒤에서 더 자세히 다루도록 하겠다.
이 글에서는 연산의 효율성을 위해 이진법을 기반으로 하면서 부호가 있는 고정 소수점을 기준으로 한다. 음수를 표현할 때는 2의 보수(2's Complement)를 사용한다. 따라서 그림에서 볼 수 있듯이 가장 왼쪽의 1비트(MSB)는 부호를 표현하기 위한 비트(Sign)로 사용된다. 그리고 IWL(Integer Word Length)은 정수 부분을 표현하는 비트의 수를 의미하며, FWL(Fractional Word Length)은 소수점 이하 부분을 표현하는 비트의 수를 의미한다. 전체 비트의 수를 WL(Word Length)이라고 할 때, FWL = WL - 1 - IWL이 성립하므로, 고정 소수점을 정의하기 위한 Parameter는 WL과 IWL 두 가지만 있으면 된다. 즉, 전체 길이가 WL비트이면서 정수 부분에 IWL비트를 사용하는 고정 소수점의 경우 (WL, IWL)와 같은 투플(Tuple)로 간단히 정의할 수 있다. 이 글에서는 편의상 F(WL, IWL)로 표기한다. 위 그림의 경우 F(16, 3)에 해당한다.

3. 부동 소수점에서 고정 소수점으로의 변환
고정 소수점을 제대로 구현하려면 우선 부동 소수점의 기본 형식부터 자세히 살펴볼 필요가 있다.  IEEE754의 표준을 따르는 32비트의 float 데이터 타입은 다음과 같은 정보를 담고 있다.
맨 왼쪽의 1비트는 부호(Sign)를 나타내는데 사용되며, 이어지는 8비트는 지수부(Exponent)를, 그리고 나머지 23비트는 실제 숫자들(Mantissa)을 표현하는데 사용된다. 이는 실수를 표현할 때 다음과 같이 정수 부분이 한 자리인 소수(가수)와 정수의 거듭제곱의 곱 형태로 나타낼 수 있다는 아이디어를 바탕으로 하는 것이다.
이 예시는 10진법을 기반으로 한 부동 소수점 방식으로 0.123을 표현한 것이다. 그런데, IEEE754의 float은 2진법을 기반으로 한다. 이는 (밑) 부분이 10이 아니라 2가 됨을 의미한다.
그렇다면, float의 세 가지 영역에 대해 자세히 살펴보도록 하자. 우선 맨 앞의 Sign 비트는 1일 경우 음수를 나타내고, 0일 경우 양수를 나타낸다. Exponent는 말그대로 (지수) 부분을 나타낸다. 단, 주의해야 할 점은 실제 (지수) 값에 127이라는 Bias를 더한 값을 저장하고 있다는 것이다. 예를 들어, 지수가 3인 경우 float의 Exponent 부분을 출력해보면 130이라는 값이 나온다. 따라서 실제 지수 값을 얻으려면 Exponent에서 127을 빼주면 된다. 마지막으로 Mantissa는 (가수) 부분을 나타낸다. 이진수의 경우 이 (가수) 부분에서의 정수 부분은 항상 1이 된다. 즉, 무조건 1.xxx와 같은 형태로 나타난다. 가장 왼쪽에 위치한 1을 기준으로 정수 부분이 한 자리수가 되도록 만들어주기 때문이다. 이러한 특성을 이용해 1비트를 절약하기 위하여 Mantissa에는 소수점 아래의 값들만 저장한다. 예를 들어, 1.11011이라는 수의 Mantissa는 맨 왼쪽의 1을 제외한 11011이 된다. 고정 소수점으로 변환할 때 이 점을 주의해야 한다.
이 정보를 바탕으로 고정 소수점으로 변환해주는 함수를 만들도록 하자. 그런데, 구현에 앞서 한 가지 짚고 넘어가야 할 것이 있다. 단순히 특정 위치에 있는 비트를 읽어서 처리를 하면 간단할 것 같지만, C++에서는 float으로 선언한 변수에 대해 비트 연산(Bitwise Operation)을 사용할 수 없다. 물론, 특정 위치의 비트에 접근조차 불가능하다. 하지만, 이는 기본으로 제공되는 ieee754.h 헤더파일을 통해 해결이 가능하다. ieee754.h에는 IEEE754 표준을 따르는 float의 Sign, Exponent, Mantissa 부분에 접근할 수 있도록 해주는 ieee754_float이라는 union이 정의되어 있다. 이를 통해 원하는 영역의 비트들을 int형으로 받아올 수 있다. (참고: https://stuff.mit.edu/afs/sipb/project/merakidev/include/ieee754.h)
앞서 고정 소수점의 정의 부분에서 언급했듯이, 이 글에서는 이진법을 기반으로 하면서 2의 보수법을 통해 부호를 표현하는 고정 소수점을 구현한다.
#include <stdio.h>
#include <ieee754.h>
#define SIGN 1
#define EXPONENT 8
#define MANTISSA 23
#define EXP_BIAS 127
#define INT_SIZE 32
 
typedef short fix16;
typedef char fix8;
 
int fix(float f, int wl, int iwl) {
    ieee754_float standard;
    standard.f = f;
 
    int ret = standard.ieee.mantissa | (1 << MANTISSA);
    int exp = standard.ieee.exponent - EXP_BIAS;
    int fwl = wl - iwl - 1;
    int fraction = MANTISSA - exp;
    int filter = (1 << wl) - 1;
 
    if(fraction > INT_SIZE) {
        ret = ret >> fraction - INT_SIZE;
        fraction = INT_SIZE;
    }
 
    ret = ret >> fraction - fwl;
 
    if(standard.ieee.negative) {
        ret = ~ret + 1;
    }
 
    return ret & filter;
}
fix 함수는 float형의 실수와 WL, IWL을 인자로 받아서 32bit의 int형 값을 반환한다. 유효한 비트들이 오른쪽으로 쏠려있기 때문에, 원하는 WL에 따라 작은 크기의 자료형(fix8, fix16 등)으로 형변환하여 사용하면 된다.
float에서 fix로 변환을 하면서 중요한 점은, float이 2의 보수법을 사용하지 않는다는 점이다. 따라서 음수의 경우 2의 보수법을 적용해주기 위해 코드의 마지막 부분에 standard.ieee.negative를 확인하여 처리하는 것을 볼 수 있다.
이 함수를 통해 3.4567을 F(16, 3)와 F(8, 3)로 변환하면 약간의 오차가 있지만 유사한 값이 출력되는 것을 볼 수 있다. 정수 부분이 4자리인 이유는 맨 왼쪽의 비트가 부호를 표현하는데 사용되기 때문이다. F(16, 3)보다 F(8, 3)이 오차가 더 큰 것을 확인할 수 있다.
부호만 바꿔서 -3.4567을 고정 소수점 방식으로 변환하면 역시 유사한 값이 나오는 것을 확인할 수 있다. 한 가지 주의할 점은, 2의 보수법으로 음수를 표현할 때 정수 부분과 소수점 이하 부분을 따로 생각하지 않고 한 몸으로 생각한다는 것이다. 즉, 이 두 부분을 합쳐서 하나의 int형 값이라고 생각하고 2의 보수법을 적용하는 것이다. 따라서, 정수 부분의 이진수가 1100인 것을 보고 십진수로 표현하면 -4이기 때문에 틀렸다고 단정지으면 안된다. 결과로 나온 위의 두 이진수들을 더해서 0이 나오는 것을 확인하면 이러한 의문이 해결될 것이라고 생각한다.

4. 고정 소수점의 사칙연산
고정 소수점 방식의 꽃은 바로 사칙연산의 효율성이다. 앞선 예시를 통해 짐작했겠지만, 2의 보수법을 적용한 고정 소수점의 경우 int형의 값들과의 사칙연산 과정이 동일해진다. 복잡한 실수의 사칙연산이 단순한 정수의 사칙연산으로 간소화되는 것이다.
같은 IWL을 가진 고정 소수점끼리의 덧셈과 뺄셈은 정수의 덧셈과 뺄셈과 완전히 동일하다. 따라서 따로 추가적인 구현을 할 필요가 없다. 그러나, 곱셈과 나눗셈의 경우는 그렇지 않다. 곱셈과 나눗셈의 과정에서는 16비트 이상의 공간을 사용해야 값의 손실없이 정확한 결과를 얻을 수 있다. 정확히 말하자면, A * B 또는 A / B의 경우는 A와 B 각각의 전체 길이를 합한 만큼의 공간이 필요하다. 따라서, 이 글에서 구현한 fix16의 경우는 16 + 16 = 32비트 크기의 int형 변수를 여분의 공간(Extra Space)으로 활용하여 연산을 진행한다.
이진수의 곱셈과 나눗셈을 하나하나 뜯어보면 다소 복잡하지만, 결국 가장 중요한 것은 결과값의 소수점의 위치이다. 이것에 집중하면 간단하게 고정 소수점 사칙연산을 구현할 수 있다.
이 글에서는 같은 IWL을 가진 고정 소수점끼리의 사칙연산을 가정한다. 그렇다면 피연산자들의 FWL도 같게 되는데, 이를 L이라고 하자. 두 개의 고정 소수점 수 A와 B에 대한 사칙연산을 수행한다고 할 때, 결과값도 역시 FWL이 L인 고정 소수점 수가 나와야 한다. A와 B에서 소수점을 찍지 않은 상태의 정수 값을 각각 a와 b라고 하면 다음과 같이 고정 소수점 수를 분수로 표현할 수 있다.
구현의 특성상 고정 소수점 방식의 소수점은 실제로 찍는 것이 아니라, 가상의 점이기 때문에 이러한 표현은 유용하다. 예를 들어, 1.011이라는 이진수가 있다면 메모리에는 1011이라는 정수만 저장된다. 즉, 앞서 구현한 fix8 또는 fix16형 변수에 저장되는 실제 값은 정수인 a와 b인 것이다. 정수 부분의 길이가 1이라는 것은 사용자가 임의로 정하는 것(IWL)이기 때문에 별도로 표시되지 않는다. 따라서 1011과 같은 정수의 사칙연산으로 문제가 바뀌게 되는 것이다.
이 분수 표현을 바탕으로 사칙연산에 대한 각각의 식을 세워보자. 연산의 결과도 FWL이 L이어야 하므로, 분모는 항상 2의 L승으로 유지해야 한다는 것에 유념한다.
알다시피 덧셈과 뺄셈은 정수의 경우와 동일하게 진행하면 되지만, 곱셈과 나눗셈의 경우 추가적인 연산이 필요하다. 곱셈의 경우는 a와 b를 곱한 결과에 2^L을 나누어주면 되고, 나눗셈의 경우는 a에 2^L을 곱한 뒤 b로 나누어주면 된다.
2의 지수승을 곱하거나 나누는 행위는 시프트 연산(Bitwise Shift Operation)를 통해 간단히, 그리고 효율적으로 수행할 수 있기 때문에 곱셈과 나눗셈은 다음과 같이 구현하면 된다.
int mul_fix(int a, int b, int wl, int iwl) {
    int c = a * b;
    return c >> wl - 1 - iwl;
}
int div_fix(int a, int b, int wl, int iwl) {
    int c = a << wl - 1 - iwl;
    return c / b;
}

5. 고정 소수점의 장단점
고정 소수점의 장점은 크게 두 가지가 있다. 첫 번째는 연산 효율성이 높다는 것이다. 앞서 살펴봤듯이, 실수 사칙연산 문제가 정수 사칙연산 문제로 바뀌기 때문에 연산에 요구되는 시스템의 자원이 줄어들게 된다.
두 번째는 적은 수의 비트를 사용한다는 것이다. 이는 특히 최근 유행하는 뉴럴 네트워크(Neural Network) 기반의 딥 러닝(Deep Learning)에서 빛을 발한다. 딥 러닝에서는 무수히 많은 수의 float형 실수를 Parameter로 사용하기 때문에, 항상 메모리 문제에 시달리게 된다. 예를 들어, 특정 Layer의 Weight 행렬의 크기가 512 x 512라면, 행렬 연산을 위해 메모리 상에 32 x 512 x 512 = 8388608 = 1GB의 공간을 확보해야 한다. 만약 8비트의 고정 소수점 방식을 사용한다면, 이 크기를 4분의 1로 줄일 수 있다. 이러한 강점은 특히 임베디드 시스템처럼 하드웨어 자원이 한정된 환경에서 유용하다.
단점은 역시 수를 표현함에 있어서 정확도가 떨어진다는 것이다. float형에 비해 적은 범위의 수만 제한적으로 표현이 가능하기 때문에 정확도를 요구하는 문제에서는 적합하지 않다.
하지만, Qiu, Jiantao, et al. "Going Deeper with Embedded FPGA Platform for Convolutional Neural Network"에 의하면, CNN을 활용한 ImageNet 이미지 분류같은 복잡한 딥 러닝 문제에서 적은 비트 수의 고정 소수점을 사용하고도 정확도 손실이 그다지 크지 않다는 점이 인상적이다. 거의 절반 혹은 4분의 1의 Bandwidth만 사용하면서 정확도의 손실을 최소화할 수 있는 F(WL, IWL)을 사용하여 메모리 부담을 덜 수 있다.

6. 고정 소수점 위치 설정
고정 소수점의 위치는 사용자의 임의대로 Static하게 설정하는 것이지만, Overflow의 발생을 최소화하고 정확도를 최대한 높이기 위해서 Dynamic하게 자동으로 설정할 수도 있다. 이를 Dynamic-precision Data Quantization이라고도 한다. 이 방법은 사용할 실수들의 값을 미리 다 알고 있다는 가정 하에 이루어진다. 간단한 두 가지 방법을 살펴보자.
첫 번째 방법은 모든 수를 검토해서 정확도의 손실이 최소화되도록 고정 소수점 수로 변환하는 것이다.
사용하고자 하는 비트 수는 WL로 고정되어 있다고 가정하고, N개의 float형 실수 x가 주어졌을 때 IWL 값을 변경해보면서 정확도의 손실이 최소가 되는 IWL을 찾으면 된다. 단, 이 방법은 부동 소수점과 고정 소수점간의 연산을 별도로 구현해야 한다는 단점이 있다.
이를 보완하기 위한 두 번째 방법을 생각해보자. 고정 소수점의 위치를 설정할 때는 사용할 데이터의 정수 부분의 범위, 즉, IWL에 주목하면 된다. 정수를 Overflow 없이 모두 표현할 수 있는 IWL의 최솟값이 가장 이상적이다. IWL이 작을수록 FWL이 커져서 소수 부분을 더욱 정밀하게 표현할 수 있기 때문이다.
이렇게 각각의 실수 중 가장 정수 부분의 수가 큰 값을 구한 뒤 Log를 취하여 IWL로 설정하면 좀 더 효율적이고 직관적으로 최적의 고정 소수점 위치를 얻을 수 있다. 이를 간단하게 코드로 구현하면 다음과 같다.
#include <math.h>
int optiwl(float floats[], int len) {
    int max, iwl = 0;
   
    for(int i = 0; i < len; i++) {
        int n = floats[i];
   
        if(n < 0) n *= (-1);
        if(max < n) max = n;
    }
   
    if(max) iwl = log2(max) + 1;
   
    return iwl;
}

7. Source Code
https://github.com/arkainoh/fixedpoint

8. References
https://en.wikipedia.org/wiki/Fixed-point_arithmetic
http://bab2min.tistory.com/183
http://www.puntoflotante.net/FLOATING-POINT-FORMAT-IEEE-754.htm
Qiu, Jiantao, et al. "Going deeper with embedded fpga platform for convolutional neural network." Proceedings of the 2016 ACM/SIGDA International Symposium on Field-Programmable Gate Arrays. ACM, 2016.

월요일, 1월 09, 2017

[Assembly] C언어 반복문은 어셈블리어로 어떻게 변환될까?

월요일, 1월 09, 2017

C언어에서 for나 while을 통해 반복문을 많이 사용하는데, 이것을 하드웨어는 어떻게 이해하는지 탐구해보자.

실험은 MIPS instruction들을 사용하는 환경에서 진행하였으며, 컴파일러는 Cygwin에서 제공하는 MIPS용 gcc를 사용하였다.

우선 for문을 사용한 아주 간단한 C 코드를 다음과 같이 작성한다.
int main()
{
  int i;
  for (i=0; i<0xFFFF; i++);
  return 0;
} 
main() 함수가 호출되면, i라는 정수형 변수를 선언하고 i의 값을 0부터 시작하여 0xFFFF가 될 때까지 1씩 증가시키다가 반복문을 빠져나가고 종료된다.

이 코드를 컴파일하면 다음과 같은 어셈블리 코드를 얻어낼 수 있다.
  1c: afc00000 sw zero,0(s8)
  20: 0800000e j 38
  24: 00000000 nop
  28: 8fc20000 lw v0,0(s8)
  2c: 00000000 nop
  30: 24420001 addiu v0,v0,1
  34: afc20000 sw v0,0(s8)
  38: 8fc20000 lw v0,0(s8)
  3c: 3403ffff li v1,0xffff
  40: 0043102a slt v0,v0,v1
  44: 1440fff8 bnez v0,28
  48: 00000000 nop
1c부터 차례차례 과정을 살펴보자. 쉽게 알아볼 수 있도록 "저장소 <= 저장할 값" 형식으로 표현하겠다.

1c:
0(s8) <= 0
메모리 주소 0(s8)에 값 0을 저장한다.

20:
38로 jump한다.

38:
v0 <= 0(s8)
v0 레지스터에 0(s8)에 저장되어 있는 0을 불러와서 저장한다.

3c:
v1 <= 0xffff
v1 레지스터에 값 0xffff을 저장한다.

40:
v0 <= 0 또는 1
v0과 v1의 값을 비교한다. 만약 v0이 v1보다 작을 경우 v0에 1을 저장하고, 그렇지 않은 경우에는 0을 저장한다. 즉, for문의 가운데 조건 부분 (i < 0xffff)을 검증하는 작업이다.
v0에는 현재의 i값인 0이 저장되어 있고, v1에는 0xffff가 저장되어 있기 때문에, v0은 1로 셋팅된다.

44:
v0에 저장되어 있는 값이 0이 아닐 경우 28로 이동한다. 바로 전 작업에서 i < 0xffff였기 때문에 v0이 1로 셋팅되어 있었다. 따라서 28로 이동한다.

28:
v0 <= 0(s8)
v0에 메모리 주소 0(s8)에 있는 값을 저장한다. 맨 처음 1c에서 0을 저장해두었으므로 v0에는 0이 저장된다.

2c:
Hazard를 피하기 위해 한 cycle을 쉰다.

30:
v0 <= v0 + 1
기존의 v0의 값에 1을 더해서 v0에 저장한다. 즉, i++를 하는 과정이다.

34:
0(s8) <= v0
30에서 더해진 결과를 메모리 주소 0(s8)에 저장해준다. 새로 변경된 i값을 업데이트 해주는 과정이다.

이후 38부터는 다시 위의 과정이 반복된다. 40에서 slt 인스트럭션에 의해 v0이 0으로 셋팅될 때까지 반복되다가 반복문을 빠져나와 프로그램이 종료된다.

[Linux/C] dup 명령어

월요일, 1월 09, 2017
dup는 사용중인 파일 디스크립터 (File Descriptor, 이하 fd)를 복사해주는 명령어이다.

unistd.h에 정의되어 있으며, 다음과 같이 두 가지 형태가 있다.
#include <unistd.h>
int dup (int filedes);
int dup2 (int filedes1, int filedes2);
filedes (또는 filedes1)에 복사하고자 하는 fd를 인자로 넣어준다.

dup() 함수는 open() 함수와 마찬가지로 할당 가능한 fd 값 중 가장 작은 번호를 return한다. 이미 예약되어 있는 0, 1, 2는 제외하고 3번부터 할당이 시작된다.

dup2() 함수는 filedes1가 참조하고 있는 파일에 대해 새로운 fd를 생성하는데, filedes2에 사용자가 인자로 제공한 값으로 생성을 한다. 즉, filedes1을 filedes2로 복사하는 것이다. 사용자가 원하는 숫자로 fd를 할당할 수 있다는 점에서 dup() 함수와 차이가 있다.

예제와 함께 살펴보자.
  1 #include <stdio.h>
  2 #include <fcntl.h>
  3 #include <unistd.h>
  4
  5 int main(void) {
  6   char *fname = "result.txt";
  7   int fd1, fd2;
  8
  9   if((fd1 = creat(fname, 0666)) < 0) {
 10     printf("creat error\n");
 11     return 1;
 12   }
 13
 14   printf("First one is on the screen.\n");
 15   fd2 = dup2(fd1, 1);
 16   printf("Second one is in this file.\n");
 17   printf("fd2:%d\n", fd2);
 18   return 0;
 19 }
15행을 보면 dup2() 함수를 사용해 result.txt 파일의 fd를 1로 복사한다. 1번 fd는 표준출력 (stdout)을 뜻하기 때문에 이후에 printf를 통해 문자열을 출력할 경우 콘솔창이 아니라 result.txt 파일로 출력이 될 것이다. 따라서 위 코드를 실행시켜보면, 콘솔창에 "First one is on the screen"이 출력될 것이고, 새로 생성된 result.txt라는 파일에 "Second one is in this file", 그리고 "1"이 출력되어 있을 것이다.

일요일, 9월 11, 2016

System Project: CPU Scheduling Simulator

일요일, 9월 11, 2016

1. Introduction
2016년 1학기 운영체제 수업에서 텀프로젝트로 진행했던 CPU Scheduling Simulator이다. 프로세스의 생명주기를 실제와 유사하게 표현하였고, 다양한 스케줄링 알고리즘들을 구현하여 각각의 알고리즘마다 어떤식으로 스케줄링이 이루어지며, 성능은 어떤지 비교분석을 해준다.
원활한 시뮬레이션을 위해 프로세스마다 CPU Burst Time을 예측할 수 있다는 전제를 바탕으로 하며, 조금 더 현실에 가깝게 하기 위해 I/O 작업을 수행하는 프로세스도 구현하였고, 역시 I/O 작업을 수행하는데 걸리는 시간도 예측할 수 있다고 전제하였다.
시뮬레이션을 하기 위한 프로세스의 갯수와, 그 중에서 I/O 작업을 수행할 프로세스의 갯수를 사용자로부터 입력받아서 여러 알고리즘들을 통해 시뮬레이션한 결과를 출력해준다.

2. Demo

3. 개발 환경
Ubuntu 16.04 LTS 환경에서 C언어로 작성하였으며, 컴파일러는 gcc 5.4.0 버전을 사용하였다. 콘솔 기반의 프로그램이기 때문에 입력과 출력이 모두 콘솔상에서 이루어진다.

4. 구현 알고리즘
FCFS (First Come First Served)
- 가장 먼저 Job Queue에 도착한 프로세스가 가장 먼저 수행되는 알고리즘이다.

SJF (Shortest Job First)
- CPU Burst Time이 가장 적게 남은 프로세스가 먼저 수행되는 알고리즘이다. Preemptive와 Non-preemptive 방식 총 두 가지로 구현하였다.

Priority
- 미리 설정된 Priority값을 기준으로 프로세스의 수행 순서를 결정해주는 알고리즘이다. 이 프로그램에서는 Priority값이 낮은 프로세스가 더 우선권을 가진다. SJF 알고리즘과 마찬가지로 Preemptive와 Non-preemtive 방식 두 가지를 모두 구현하였다.

Round Robin
- 시스템에 설정된 Time Quantum을 기준으로 일정 시간마다 수행될 프로세스를 변경해주는 방식이다. Time Quantum이 만약 무한대라면, 특정 프로세스가 먼저 리소스를 점거할 경우 종료가 될 때까지 다른 프로세스들이 수행되지 않기 때문에, FCFS 방식과 동일해진다.

LIF (Longest I/O First)
- I/O 작업을 수행하는 시간이 긴 프로세스가 후반부에 스케줄링될 경우 CPU의 유휴상태가 발생할 확률이 높아진다는 점에 착안하여 가장 I/O Burst Time이 큰 프로세스부터 우선적으로 스케줄링해주는 방식이다. Preemptive / Non-preemptive 방식 둘 다 구현하였다.

LISC (Longest I/O & Shortest CPU First)
- LIF가 CPU Burst Time을 고려해주지 않는다는 단점을 보완하여 CPU Burst Time도 스케줄링에 반영한 알고리즘이다. Preemptive / Non-preemptive 방식 둘 다 구현하였다.

5. 사용법
Github에서 실행파일(CPUScheduler)을 다운받아서 콘솔에서 실행시키면 된다. 이때 인자로 두 개의 정수를 넘겨주어야 하는데, 첫 번째는 전체 프로세스의 갯수, 두 번째는 그중에서 I/O 작업을 수행할 프로세스의 갯수이다. I/O 작업을 수행할 프로세스가 전체 프로세스의 수보다 많을 경우 실행되지 않는다. 나머지 여러 속성들은 프로그램 내에서 자동으로 임의적으로 설정된다.
출력되는 내용이 비교적 긴 편이기 때문에 외부 파일에 출력내용을 저장해서 보는 것을 추천한다. 예를 들어 다음과 같이 콘솔창에 입력하면 된다.
./CPUScheduler 10 3 >> result.txt

6. Source Code
자세한 사항은 Github에서 확인할 수 있다. 전체 소스코드와 실행파일 및 보고서가 포함되어 있다.
https://github.com/arkainoh/CPU-Scheduling-Simulator

수요일, 7월 27, 2016

OpenCV 다운로드 및 시작하기 with Visual Studio 2012 (Visual C++)

수요일, 7월 27, 2016
How to download and start OpenCV?


Opencv는 이미지/영상 프로세싱을 해주는 대표적인 오픈소스 중 하나이다. C언어의 라이브러리 형태로 제공되기 때문에 쉽게 다룰 수 있으며, C++, Java, Python 등 다른 언어들과도 호환이 된다는 장점이 있다.

물체인식, 안면인식 등에 사용되는 유용한 툴인 OpenCV를 다운로드하고 개발환경을 세팅하는 법을 알아보겠다. C++언어를 사용하는 것을 전제로 진행하겠다.

우선 준비물은 2가지이다. 첫 번째는 대표적인 C/C++ 개발용 IDE인 Visual Studio 2012이고, 두 번째는 바로 OpenCV 라이브러리 파일이다.

Visual Studio 2012는 다음의 링크에서 다운로드받을 수 있다. 반드시 2012 버전을 다운받기를 권한다. 상위버전을 사용할 경우 Compiler의 버전이 다르기 때문에 OpenCV가 정상적으로 동작하지 않을 수도 있다.


그리고 다음의 링크에서 자신의 운영체제에 맞는 OpenCV 라이브러리를 다운로드 받으면 된다.


다운로드가 완료되었다면, OpenCV 압축파일을 압축해제해서 사람의 손길이 닿지 않는(?) 경로에 두면 된다. 되도록이면 경로명에 한글이 포함되지 않도록 주의한다.

그 다음엔 (Window를 기준으로) 고급 시스템 설정에 가서 OpenCV의 bin 디렉토리를 환경변수를 추가해주어야 한다. 압축해제한 경로에 가보면 opencv라는 루트 디렉토리가 있고 그 안에 build라는 디렉토리가 있을 것이다. 자신의 운영체제에 맞게 x64 혹은 x86이라는 디렉토리에 들어가면 vc11, vc12라는 두 개의 디렉토리가 있을 것이다. vc11이 Visual Studio 2012를 뜻하는 것이고 vc12가 2013 버전을 뜻하는 것이기 때문에, vc11 디렉토리로 이동한다. (자신이 사용하는 Visual Studio의 뒤에 붙은 연도의 끝 두 자리에서 1을 뺀 것과 같음) 이제 이 디렉토리 안의 bin 디렉토리를 환경변수 (PATH)에 추가해주면 된다.

예시: C:\opencv\build\x86\vc11\bin

환경변수까지 추가했다면 이제 Visual Studio와 연동시킬 일만 남았다. Visual Studio 2012를 실행한 뒤 Visual C++ Win32용 콘솔 응용프로그램으로 빈 프로젝트를 하나 만들어준다. 앞으로 진행할 간단한 물체인식 예제를 해보는 차원에서 프로젝트 이름은 BallDetection으로 지었다.


프로젝트가 생성되었으면 프로젝트(P) 탭의 속성(P)로 간다. 처음으로 나타나는 화면인 구성속성 - 일반에서 플랫폼 도구 집합이 Visual Studio 2012 (v110)으로 올바르게 설정되어 있는지 확인한다.


확인을 완료했으면 구성속성 - VC++ 디렉터리로 넘어간다.


여기서 첫 번째로 포함 디렉터리 (Include Directory) 편집에 들어가서 'OpenCV를 설치한 곳\opencv\build\include'를 추가해준다.
그리고 두 번째로 라이브러리 디렉터리 (Library Directory) 편집에 들어가서 'OpenCV를 설치한 곳\opencv\build\x86 또는 x64 (자신에게 맞게)\vc11\lib'를 추가해준다.

예시: C:\opencv\build\x64\vc11\lib

두 개 다 추가를 완료 했다면 구성속성 - 링커 - 입력으로 넘어간다.


추가 종속성 편집에 들어가서 다음의 목록들을 붙여넣기 한다.

opencv_calib3d2413d.lib
opencv_contrib2413d.lib
opencv_core2413d.lib
opencv_features2d2413d.lib
opencv_flann2413d.lib
opencv_gpu2413d.lib
opencv_highgui2413d.lib
opencv_imgproc2413d.lib
opencv_legacy2413d.lib
opencv_ml2413d.lib
opencv_nonfree2413d.lib
opencv_objdetect2413d.lib
opencv_ocl2413d.lib
opencv_photo2413d.lib
opencv_stitching2413d.lib
opencv_superres2413d.lib
opencv_ts2413d.lib
opencv_video2413d.lib
opencv_videostab2413d.lib

추가종속성 편집까지 완료됐다면, 이제 OpenCV를 시작할 준비가 된 것이다.